次世代のビジネスをつくる、実装と教育のメディア。
検索メニュー
キーワードで探す

ハルシネーション(hallucination、幻覚)とは、生成AIが事実でない情報を、事実と同じ自信でもっともらしく生成してしまう現象です。仕組み上ゼロにはできないため、対策の本質は「AIを疑うこと」より「確認の工程」をつくることにあります。
たとえば、生成AIに調べ物を頼んだら、それらしい判例や論文を挙げてきました。安心して資料に貼りました——でも、その判例はそもそも実在しませんでした。こんな事故が、いま世界中で実際に起きています。しかもAIは、嘘を嘘とわかる書き方では出しません。本物の情報と寸分違わない、自信たっぷりの文体で、しれっと混ぜてきます。だから怖いのです。
今回は、なぜこれが起きるのか(実はこれまでの記事が、全部その伏線でした)、なぜ消せないのか、そしてどう付き合えばいいのかを、国内外の事故事例と、確認時にそのまま使えるチェックリストもまじえて整理します。
ハルシネーションとは、生成AIが事実に基づかない情報を、あたかも事実であるかのように生成してしまう現象です。存在しない判例、書かれていない論文、実在しないURL、微妙に違う数値——それらを、本物の情報とまったく同じ自信度・同じ文体で出力します。
厄介なのは、「ここは自信がありません」という顔を一切しないことです。人間なら曖昧なことは口ごもったり「たぶん」と前置きしたりしますが、AIは間違っているときも堂々としています(むしろ間違っているときほど、自信満々なことすらあります)。だから読み手は「変だな」と気づけないまま、資料や顧客対応にそのまま使ってしまいます。ここに、ハルシネーションの本当の危うさがあります。
ではなぜ、AIは平気で嘘をつくのでしょうか。実はその答えは、この連載でこれまで説明してきたAIの仕組みそのものにあります。
理由1:AIは「正しい言葉」ではなく「それらしい言葉」を選んでいる
生成AIは「考えて」いないで見たとおり、AIは事実のデータベースを引いて答えているのではなく、「この文脈なら次に来そうな言葉」を確率で選んで文章をつむいでいます。つまりAIが得意なのは「もっともらしさ」を作ることであって、「正しさ」そのものは保証されていません。学習データに答えがそのまま無い質問でも、文章として自然な「それらしい回答」を作れてしまう——これが根っこです。
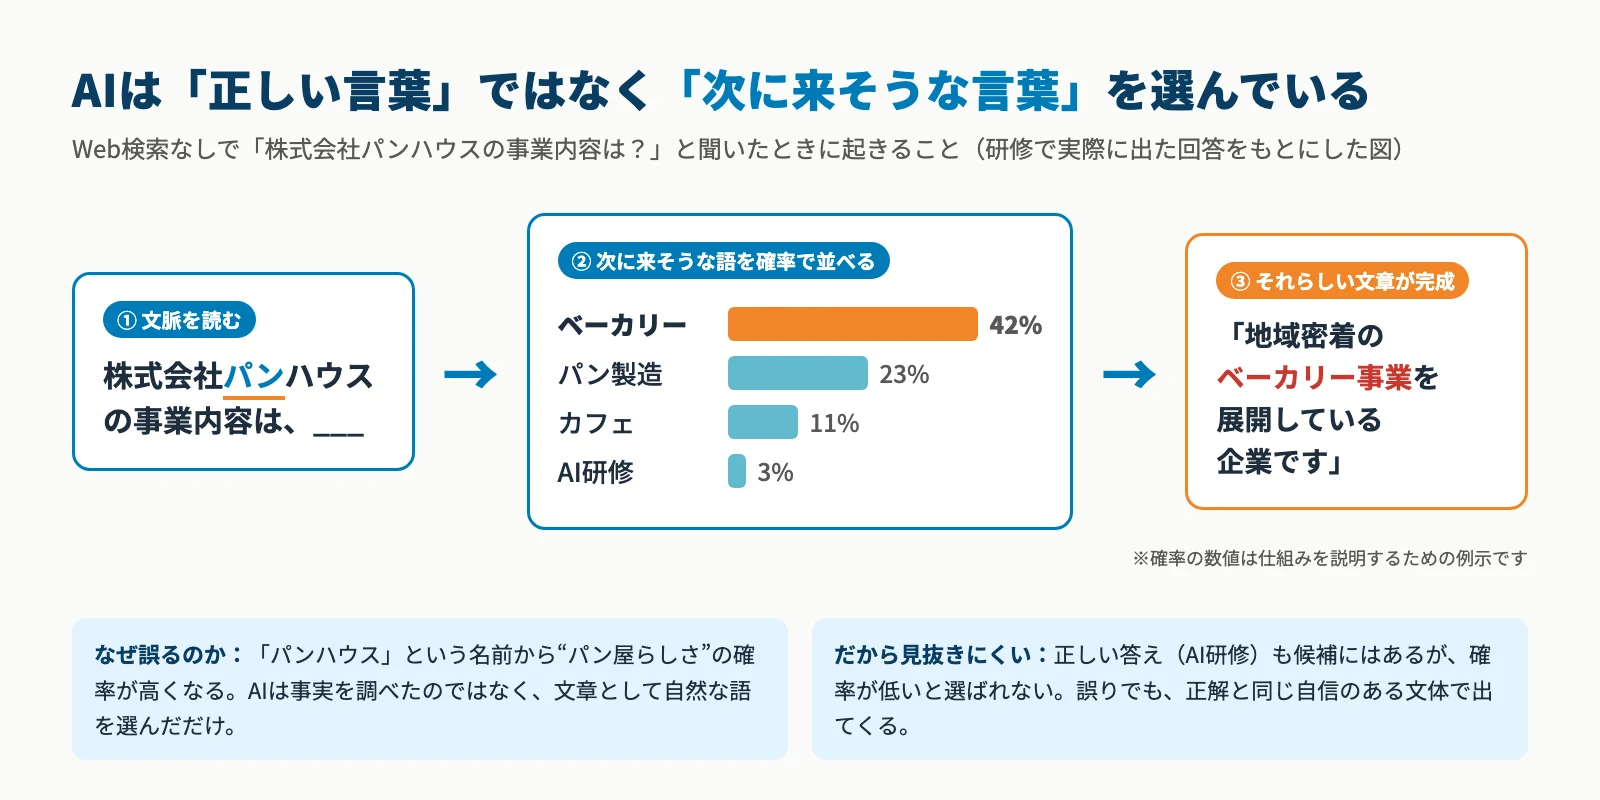
上の図は、後で紹介する研修現場の実例をもとにしています。「パンハウス」という名前からは“パン屋らしい続き”の確率が高くなるため、AIは事実を調べることなく「ベーカリー事業」という文章を完成させてしまいます。正しい答えも候補には入っていますが、確率が低ければ選ばれません。
理由2:「わからない」より、答えた方が得をするように育っている
OpenAIなどの研究者らが2025年9月に公開した論文「Why Language Models Hallucinate」は、AIの学習・評価のしくみ自体が、「わかりません」と答えるより(間違っていても)自信を持って答えるほうを高く評価してしまう構造になっている、と指摘しています。正解なら1点、空欄は0点という試験なら、わからなくても何か書いたほうが点を取れる可能性がある、というのと同じです。だからAIは「知らないなら黙る」より「推測してでも埋める」方向にクセづきやすいのです。
理由3:知らないこと(カットオフの外)は、推測で埋める
AIは「いつまでの世界」を知っているかで触れたように、AIは学習した時点までの知識しか持ちません。その外側——最新の出来事、社内だけの情報、ニッチな統計——を聞かれると、近そうな情報から推測で埋めてしまいます。
理由4:数値・固有名詞・URL・文献に、特に弱い
文章の自然さは得意でも、「厳密に1つだけ正しい値」が求められる計算・日付・URL・文献情報などは、似た形のもっともらしい値を「作文」しがちです。ChatGPTに参考文献付きの短い学術論文を書かせた研究では、挙げられた文献のうち実在しないものの割合が、GPT-3.5で55%、GPT-4でも18%ありました(Walters & Wilder, Scientific Reports, 2023)。金額や引用元をAIにそのまま任せるのが危ないのは、このためです。
ここが一番大事なところです。ハルシネーションは、モデルが新しくなれば消えるバグではなく、確率で言葉を選ぶという仕組みがある限り、一定確率で起き続ける仕様です。
だから、「賢いAIを選べば大丈夫」「考えさせれば正確」という発想はいったん捨てて、消えない前提で付き合い方を設計する——これがこの記事の結論の骨です。
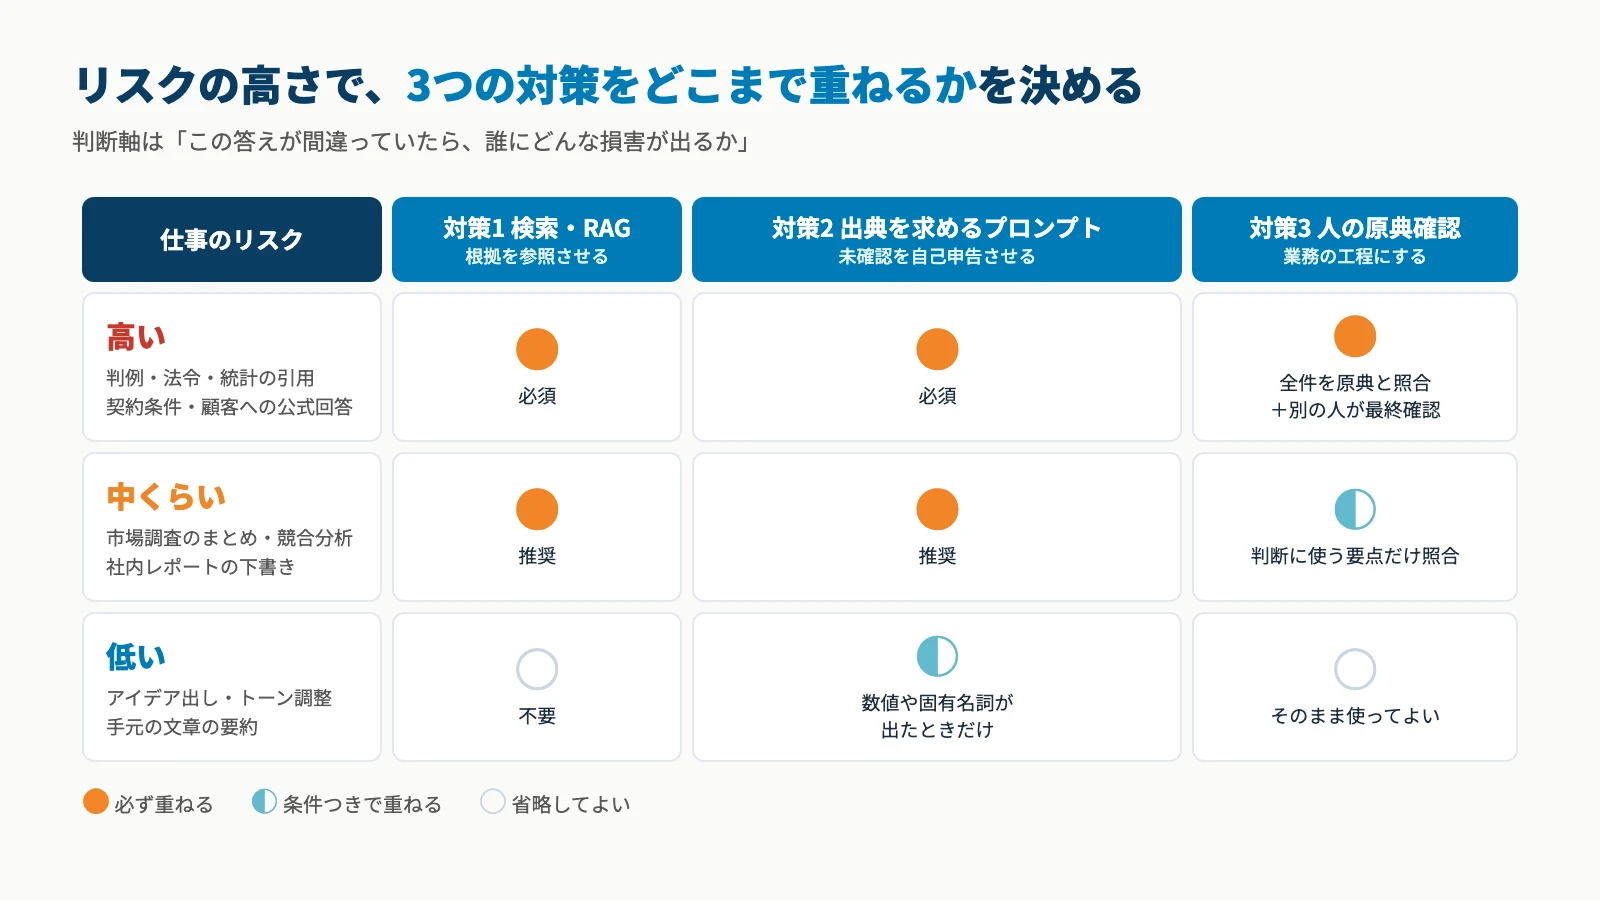
とはいえ、すべての作業で神経質になる必要はありません。大事なのは「AIを使うかどうか」ではなく、どこまでAIの答えを鵜呑みにできるかを、仕事ごとに見極めることです。目安は次のとおりです。
| リスク | こんな仕事 | 付き合い方 |
|---|---|---|
| 高い | 判例・法令・統計数値の引用、契約条件、顧客への公式回答——正解が1つで、間違いが外に出る/法的な力を持つ | 必ず人間が全てチェック |
| 中くらい | 市場調査のまとめ、競合分析、社内レポートの下書き——社内向けだが判断に影響する | 要点だけ元資料と照合 |
| 低い | アイデア出し、文章のトーン調整、手元にある文章の要約——正解が1つに定まらない/間違っても実害が小さい | そのまま使ってOK |
判断軸はシンプルに、「この答えが間違っていたら、誰にどんな損害が出るか」です。損害が「自分の作業のやり直し」で済むならAI単独でかまいません。しかし「対外的な発言」「金額」「法的判断」に関わるなら、必ず人間の原典確認をはさみます。この線引きだけで、事故のほとんどは防げます。
次の章で紹介する3つの対策を、リスクの高さに応じてどこまで重ねるかを図にすると、こうなります。
消せない前提で、発生確率を下げ、出てしまった嘘を検知します。実務では次の3つを組み合わせます。
対策1:Web検索やRAGで、AIの「記憶」だけに頼らせない
AIに丸暗記から答えさせるより、「調べてから答えさせる」方が幻覚は減ります。ChatGPT・Claude・GeminiのWeb検索をオンにすると、回答に出典リンクが付き、元ページを確認できます。さらにRAG——社内マニュアルなど決まった資料だけを参照させるしくみ——を使えば、「その資料に無いことは答えない」形に寄せられます。Gemini Notebook(旧NotebookLM)のように、アップロードした資料だけを情報源にするツールも有効です。
過信は禁物:検索やRAGを使っても、AIが検索結果を誤読して幻覚が残ることはあります。「出典が付いた=正しい」ではなく「出典を確認できる状態になった」だけです。リンク先を実際に開く習慣はセットです(提示されたURL自体が実在しない、なんてこともあります)。
対策2:プロンプトで出典を求め、自分で検算・自己チェックさせる
指示の書き方でも、かなり抑えられます。効くのは精神論(「嘘をつかないで」)ではなく、具体的な行動の指定です。用途別に、そのまま貼って使える指示文をまとめました。
| 用途 | そのまま使える指示文 |
|---|---|
| 調べもの | 事実・数値・法令名・文献名には、必ず出典(URL・文献名・発行年)を付けてください。出典を示せない情報は断定せず「未確認」と明記し、わからないことは「わかりません」とだけ答えてください |
| 資料の要約 | 添付した資料だけを根拠に要約してください。資料に書かれていない情報は加えないでください。各要点に、該当するページ番号か見出しを添えてください |
| 対外文書の点検 | この文書に含まれる事実・数値・固有名詞・日付をすべて抜き出し、「出典で確認できる/推測で未確認」に仕分けて表にしてください |
回答が出たあと、「いま挙げた事実を1つずつ、『出典で確認できる/推測で未確認』に仕分けて再提示して」と追わせると、あやしい箇所が自分で炙り出されます。数値なら「別の手順でもう一度計算して、2つが一致するか確かめて」と検算させると気づきやすくなります。指示の組み立て方そのものは、生成AIへのプロンプトの書き方で詳しく解説しています。
対策3:最後は人間——ファクトチェックを業務の「工程」にする
どれだけ工夫しても、最後の砦は人間です。ポイントは、確認を個人の心がけでなく業務の工程として組み込むことです。
これは大げさな話ではありません。法務、カスタマーサポート、報道、調査報告、地域PRと、すでにさまざまな業務で実害の出た事例があります。いずれも公的な決定文・当事者の発表・報道で確認できたものです(2026年9月27日確認)。
5件に共通するのは、AIの出力そのものより「原典と照合する工程が無い、または形だけだったこと」が損害につながっている点です。判例・規約・書名・文献・地名と対象は違っても、原典を1回開けば防げた事故ばかりでした。
事例から逆算した、AIを使った成果物を社外に出す前の確認項目です。高リスクの仕事では全項目、中リスクの仕事では該当する項目だけ確認してください。表のままコピーして社内ルールに貼り付けられます。
| # | 確認する箇所 | 確認のしかた |
|---|---|---|
| 1 | 固有名詞(人名・社名・製品名・地名・施設名) | 公式サイトや公的な情報で実在を確かめる |
| 2 | 数値・金額・統計 | 原資料を開き、数字だけでなく単位・対象年・対象範囲まで照合する |
| 3 | 日付・期間・期限 | 元の告知文・契約書・公式発表で確かめる |
| 4 | URL・リンク | 実際に開き、主張している内容がそのページに書かれているかを見る |
| 5 | 引用・発言 | 原文にその文言があるか。言い換えを「」付きの引用にしていないか |
| 6 | 判例・裁判例 | 裁判所の判例データベースなどで、事件番号から実在を確かめる |
| 7 | 法令・条文 | e-Gov法令検索などで最新の条文と施行日を確かめる |
| 8 | 文献・書籍・論文 | 書誌データベース(国立国会図書館・CiNiiなど)や出版社サイトで実在を確かめる |
| 9 | 要約の抜け・すり替え | 元資料と並べ、結論・条件・例外が落ちていないか、主語が入れ替わっていないかを見る |
| 10 | 根拠の見えない断定(「必ず」「〜と定められている」など) | 根拠を示せないものは「未確認」と書き直すか、削る |
迷ったときの基準は1つだけです。「この箇所が間違っていたら、誰が困るか」を考え、困る人が社外にいるなら原典を開いてください。
ここまでは仕組みと対策の話でしたが、最後にひとつ、私たちパンハウスが300社を超える企業研修の中で実際に見てきた「生のハルシネーション」を紹介します。
研修では、受講者に「AIにわざとハルシネーションを起こさせてみる」という体験演習を行うことがあります。実在しない事柄について、Web検索をオフにした状態で断定的な回答を求める、という単純な仕掛けです。
あるメーカー企業の研修では、受講者が「実在しない工具」について、実在するメーカー名を添えて質問したところ、AIは「対応できます」ともっともらしく回答しました。存在しない製品でも、実在する企業名と組み合わせるだけで、AIは違和感なく「作文」してしまいます。
あるサービス業の研修では、「自社に存在しない部署」について聞いてみたところ、AIは似た業態の実在組織の活動内容を土台に、もっともらしい部署紹介文を生成しました。手元にない情報でも、近そうな情報から違和感なく埋めてしまうのは、前述の「理由3」そのものです。
そして私たち自身も、ある研修で「材料」にされたことがあります。冒頭の仕組み図のもとになった例を、入力から確認までの流れで示します。
| 段階 | 内容 |
|---|---|
| 入力(受講者) | Web検索をオフにした状態で「株式会社パンハウスの事業内容は?」と質問 |
| AIの出力 | 「地域密着のベーカリー事業を展開している企業です」ともっともらしく回答 |
| 原典確認 | 公式サイトの会社概要を開けば、生成AI研修やAIソリューション開発の会社だとすぐにわかる |
生成AI研修の会社が、AIに架空のパン屋にされる——笑い話のようですが、「本物と同じ自信度で、いくらでもそれらしい話を作れる」という、この記事の主張を体現した実例です。そして、原典を1回開くだけで防げるという点も、事例5選と同じです。
一方で興味深いのは、最近の研修ではこの演習自体が「成功しにくくなってきている」ことです。以前は簡単に嘘を引き出せていたのが、最新モデルでは「その情報は確認できません」「実在するか分かりません」と、AIの側が先に音を上げるケースが増えています。モデルの改善は着実に進んでいますが、それでも上記のように「実在する要素と組み合わせる」「近い類似ジャンルで埋める」パターンでは、まだ簡単に嘘が出てくる——これが現場感覚です。
Q. ハルシネーションの意味は?
生成AIが事実に基づかない情報を、事実と同じ顔でもっともらしく生成してしまう現象のことです。英語の hallucination(幻覚)に由来します。存在しない判例・論文・URL・数値などを、本物と同じ自信度で出力するのが特徴です。
Q. なぜAIは平気で嘘をつくのですか?
AIは事実のデータベースを引いているのではなく、「次に来そうな言葉」を確率で選んで文章を作っているためです。さらに学習のしくみ自体が「わからない」と答えるより推測してでも答える方を高く評価しがちなことも、拍車をかけています。つまり不具合ではなく、仕組みに根ざした仕様です。
Q. AIが存在しない言葉や本を出すのはなぜですか?
AIは言葉を「実在するかどうか」ではなく「それらしく続くかどうか」で選んでいるためです。書名や専門用語は、実在の作家名や似た言葉の組み合わせから、いかにもありそうな形で作れてしまいます。聞き慣れない言葉や本が出てきたら、辞書・書誌データベース・出版社サイトで実在を確かめてください。
Q. ハルシネーションは最新モデルで減っていますか?
各社の自社評価では減っています。たとえばOpenAIは、GPT-6 Astra のシステムカードで、前の世代の GPT-5.6 Sol より事実の誤りが大幅に少ないと公表しています。ただしこれは、ユーザーが誤りを報告した会話など、誤りが起きやすい場面を集めて測った結果で、実際の利用時の誤り率そのものではありません(GPT-6 Astra System Card、2026年9月)。ただし測り方で結果は大きく変わり、文書の要約に限った第三者の比較(Vectara、2026年9月22日更新版)では、OpenAI・Anthropic・Googleの最新モデルでも6〜13%程度の幻覚が残り、新しいモデルが必ずしも低いわけではありません(いずれも2026年9月27日確認)。「減ってはいるが、ゼロにはならない」と考えるのが実務的です。
Q. ハルシネーションは対策できますか?
ゼロにはできませんが、減らす・検知することはできます。実務では「Web検索やRAGで根拠を参照させる」「プロンプトで出典を要求する」「人間の原典確認を業務の工程に組み込む」の3つの組み合わせが基本です。リスクの高い仕事(対外発信・金額・法的判断)ほど、人間の確認を必ずはさみます。
次にAIへ数値や引用を含む回答を頼むときは、「出典を明記して」と一言そえて、出てきたURLを1つだけでも開いてみてください。その一手間が、「もっともらしい嘘」から身を守る、いちばん確実な習慣です。
確認日はいずれも2026年9月27日です。
ハルシネーションが起きる仕組み
最新モデルでも幻覚は残る
事例1:弁護士が架空の判例を提出して制裁(法務)
事例2:航空会社チャットボットの誤案内(カスタマーサポート)
事例3:推薦図書リストに架空の本(広報・報道)
事例4:政府向け報告書に架空の文献(調査報告書)
事例5:観光キャンペーンのサイトに架空の祭り(地域PR・国内)
この記事を書いた人


 お役立ち資料