次世代のビジネスをつくる、実装と教育のメディア。
検索メニュー
キーワードで探す

「入力100万トークンあたり2ドル」「コンテキストウィンドウは20万トークン」——AIの料金表や仕様には、必ず「トークン」という言葉が出てきます。でも、その正体をきちんとイメージできている人は多くありません。
実は、このトークンを理解すると、「なぜ思ったより料金が高いのか」「なぜこの資料は読み込めないのか」といった、AIの“お金と容量”にまつわる疑問が一気につながります。この記事では、その「トークン」を正面から見ていきます。
トークンとは、AIが文章を処理するときの最小単位です。私たちが文章を「単語」や「文字」で捉えるように、AIは文章をまず「トークン」という小さなかけらに分割し、それを一つずつ扱っています。
ポイントは、「1文字=1トークン」でも「1単語=1トークン」でもないこと。AIは、学習データによく出てくる文字のかたまりを1つのトークンにまとめ、逆に珍しい単語は複数のトークンに分割します。たとえば英語の “tokenization” は、OpenAIのモデル(GPT-5.xなど)では “token” + “ization” の2個のトークンに分かれます。
日本語の文章でも見てみましょう。「生成AIのトークンとは、AIが文章を処理する最小単位です。」という29文字の文を、同じくOpenAIのトークナイザー(文章をトークンに区切るしくみ)で区切ると、次の21個のトークンになります。
生成|AI|の|ト|ーク|ン|とは|、|AI|が|文章|を|処|理|する|最|小|単|位|です|。
「生成」「文章」「です」のようによく使われる言葉は2文字で1トークンにまとまる一方、「トークン」は「ト」「ーク」「ン」の3つに、「処理」「最小単位」は1文字ずつに分かれています。どこで区切るかは、AIが学習した文章にどれだけよく出てきたかで決まるため、人間の感覚とは必ずしも一致しません。なお、この例は29文字で21トークンと、1文字あたり1トークンを下回っています。日本語の換算の目安は、このあとの「日本語のトークン数の目安」の章で詳しく紹介します。
この区切り方は、OpenAIが無料で公開しているTokenizerで誰でも確かめられます。使い方は、ページを開いて入力欄に文章を貼り付けるだけです。トークン数と文字数が表示され、文章のどこでトークンが区切られたかが色分けで示されます。
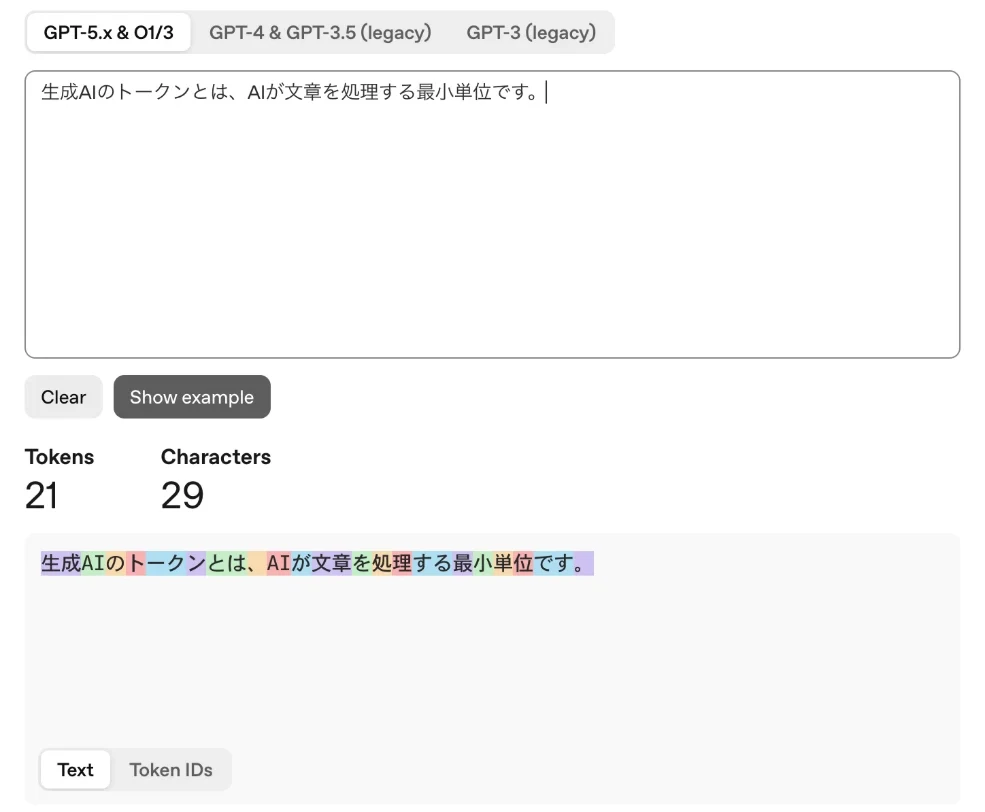
先ほどの例文を入力した画面。29文字が21トークンに区切られ、区切り位置が色分けで表示されます。上部のタブで数え方の対象モデル(GPT-5.xなど/旧モデル)を切り替えられます。
自分がふだん書いているメールや資料の一部を貼ってみると、「思ったよりトークン数が多い」「この言葉は細かく分かれる」といった感覚がつかめます。なお、トークンの区切り方はAIの種類(モデル)ごとに異なります。このページで数えられるのはOpenAIのモデルでの数なので、ClaudeやGeminiで使うときは目安として見てください(各社のAPI=プログラムからAIを呼び出す窓口には、正確なトークン数を数える機能が用意されています)。
生成AIは「考えて」いないで「AIは次に来る言葉を確率的に予測している」と説明しましたが、その“言葉”の正体が、このトークンです。AIは「次に来るトークン」を一つずつ予測して、文章をつむいでいるわけです。
トークンを知るべき理由は、AIを使ううえでの根っこに直結しているからです。
さらに、画面に表示されない「思考トークン」(推論モデルが答える前に内部で考える分)も課金対象になることがあります(この話はAIモデルはどこが進化するのかで触れています)。
つまりトークンは、AIを使うときの「通貨」のようなもの。料金も、どれだけ読み込めるかも、すべてこの単位で数えられているのです。
コンテキストウィンドウとは、AIが1回の応答をつくるときに、一度に読み込んでおける情報量の上限のことです。単位はトークンで、「100万トークン」のように表します。
ここに入るのは、貼り付けた資料だけではありません。システム側の指示、それまでの会話の履歴、添付した画像やPDF、AIが使ったツールの実行結果、そしていま書いている回答そのものまで、すべてがトークンに換算されて、この1つの枠に積み上がっていきます。机の広さにたとえると、机に載せきれない資料は、AIの目に入らないということです。
主要モデルのAPIでの上限は次のとおりです(2026年9月時点、各社の公式ドキュメントより)。
| 会社 | モデル | コンテキストウィンドウ(入力できる量) | 1回に出力できる量 |
|---|---|---|---|
| Anthropic | Claude Fable 5.1 / Opus 5.5 / Sonnet 5 | 100万トークン | 12.8万トークン |
| Anthropic | Claude Haiku 4.5 | 20万トークン | 6.4万トークン |
| OpenAI | GPT-6 Astra / Sol / Luna | 105万トークン | 12.8万トークン |
| Gemini 3.1 Pro(プレビュー版)/ 3.8 Flash / 3.5 Flash-Lite | 約105万トークン(1,048,576) | 約6.6万トークン(65,536) |
公式ドキュメント:Anthropic(Claude)/OpenAI/Google(Gemini)
いまの主力モデルは、どの会社もほぼ100万トークン前後でそろっています。次の章で紹介する目安(日本語の文字数×1)で換算すると、日本語で約100万字。一般に文庫本は1冊10万字前後と言われるので、10冊分ほどを一度に読み込める計算です。なお、Anthropicの公式ドキュメントには「100万トークンは約250万文字」とありますが、これは英語の文章を前提にした数字です。日本語では1文字あたりのトークン数が多いため、同じ100万トークンでも入る文字数は少なくなります。
表の右の列の「1回に出力できる量」は、AIが一度に書き出せる回答の長さの上限です。こちらは入力よりずっと小さく、長い報告書を一度に丸ごと書かせようとすると途中で止まることがあります。その場合は、章ごとに分けて書かせるのが確実です。また、推論モデルが答える前に内部で考える「思考トークン」も、この出力の上限の中から使われます。じっくり考えさせるほど、実際に書き出せる回答は短くなる点にも注意してください。
コンテキストウィンドウを超えそうになったときの動きは、使い方によって違います。
/compactも同じ仕組みです)コンテキストウィンドウについては、よくある誤解が2つあります。
大事な指示は会話の最初にまとめて伝え、用件が変わったら新しいチャットに切り替える。資料は必要な部分だけを渡す。コンテキストウィンドウと上手につきあうコツは、トークンを節約するコツとほとんど同じです。
モデルが更新されるときに、この枠がどう変わるかについてはAIモデルはどこが進化するのかで詳しく解説しています。
ここが、日本語で使う私たちにとって見逃せないポイントです。
同じ内容を書いても、言語によってトークン数は変わります。目安はこうです(2026年9月時点、OpenAIのTokenizerで計測)。
「日本語は1文字で1〜2トークン」と言われていたのは、数年前のモデル(GPT-3の頃)の話です。当時の数え方では、同じ日本語の文章が1文字あたり約1.3トークンになっていました。いまのトークナイザーは日本語をまとめて区切れるようになり、1文字1トークンを切るところまで改善しています。
それでも、日本語が「損」をしやすいことは変わりません。この記事から4つの文を抜き出し、日本語と英語で書き比べて数えると、日本語は134トークン、同じ内容の英語は86トークン。同じことを伝えるのに、日本語は英語の約1.5倍のトークンを使います。「文字数は少ないのに、料金は思ったより高い」「資料の枠が早く埋まる」という現象は、これが原因です。
さらに、数え方はAIの種類(モデル)ごとに違います。たとえばClaudeは、新しい世代のモデル(Claude 4.7以降)で数え方を変えており、Anthropicの公式ドキュメントによれば、同じ文章でも以前より約3割多いトークン数になります。
ざっくりした見積もりには、次の式が便利です。
必要なトークン数(概算)= 日本語の文字数 × 1(予算を組むときは、2〜3割の余裕を見てください)
たとえば4万字の議事録なら、約4万トークン。予算を見積もるなら5万トークン前後、という具合です。実際のトークン数は、先ほど紹介したTokenizerに文章を貼れば確かめられます。
とはいえ、いつでも神経質になる必要はありません。ふだんのチャット画面(ChatGPTやClaudeのアプリ)から使うぶんには、料金は定額または無料なので、トークンの消費量そのものを気にする場面はほとんどありません。
ただし、チャットでも注意が要るのが、同じセッションで延々と会話を続けたり、一度に大量のファイルを読み込ませたりするときです。コンテキストウィンドウ(一度に扱える上限)を超えてしまうと、序盤に伝えた指示を忘れたように振る舞ったり、資料の一部が読み飛ばされたりします。用件が変わったら新しいチャットに切り替えるのが、いちばんの対処です。
一方、料金の面でトークンを本格的に意識すべきなのは、主に次の2つの場面です。
場面1:APIでワークフローに組み込み、何千・何万回と実行するとき
AIをシステムに組み込んで自動で大量に処理させる場合、料金は「回数 × トークン数」で積み上がります。ここでは、毎回繰り返される指示文(システムプロンプト)を1トークンでも短くする工夫が、回数のぶんだけ効いてきます。先ほどのTokenizerで実際のトークン数を数えておくと、コストの試算もぶれません。
場面2:AIエージェントを使うとき
AIエージェントは、自律的に何度もAIを呼び出し、そのたびに増えていく作業履歴やツールの実行結果を読み込みます。そのためトークンを一気に消費し、上限に達しやすい。上限にぶつかると、作業が途中で止まったり、精度が落ちたりします。どれくらい“一気に”なのか、次の章でClaude Codeを例に具体的に見ていきます。
Claude Codeは、Anthropicが提供するAIエージェントです。サブスクリプションで使う場合は「5時間ごと」と「週ごと」の利用枠があり、枠はトークンの消費量で減っていきます(詳しくはClaude Codeの料金)。チャットと同じ感覚で使っていると「まだ数回しか頼んでいないのに枠が尽きた」ということが起こります。その理由を分解してみましょう。
たとえば「このフォルダにある今月の請求書(PDF)から金額を拾って、取引先ごとの一覧表をExcelで作って」と一言頼むと、Claude Codeはおおむね次のように動きます。
人間から見れば1往復のやり取りですが、AIの側ではツールを1回使うたびに、それまでの会話全体とツールの実行結果をまとめてもう一度読み込んでいます。読んだ請求書の中身や作業の結果は会話にどんどん積み上がるので、手順が進むほど1回あたりの読み込み量も増えていきます。チャットで1問1答するのとは、消費の桁が違うわけです。
会話の中身とは別に、Claude Codeがセッションの開始時から持ち歩いている情報もあります(2026年9月時点)。
| 読み込まれるもの | いつ・どれだけ読み込まれるか |
|---|---|
CLAUDE.md(プロジェクトの指示ファイル) |
セッション開始時に全文。公式は200行以内を推奨 |
自動メモリ(MEMORY.md) |
セッション開始時に先頭200行または25KBまで |
| スキル | 開始時は説明文だけ。本文は使うときに読み込み |
| MCP(外部ツール連携) | 開始時はツール名とサーバーの説明だけ。詳細な定義は使うときに読み込み |
| 会話履歴・読んだファイル・コマンドの出力 | 作業が進むほど積み上がる |
つまり、CLAUDE.mdに長々と書き込んだ内容は、関係のない作業をしているときでも毎回トークンを消費します。特定の作業でしか使わない手順は、必要なときだけ読み込まれる「スキル」に移すのが公式の推奨です。
加えて、Claude Codeは答える前に内部で「考える」処理(拡張思考)が標準でオンになっています。この思考トークンは出力トークンとして数えられ、1回の依頼で数万トークンに及ぶこともあります。
Claude Codeには、画面のスクリーンショットや仕様書のPDFをそのまま読ませることもできます。便利な反面、文字だけのファイルに比べてトークンの消費が桁違いに大きくなりやすいので注意が必要です(2026年9月時点)。
さらに厄介なのは、一度読ませたファイルは会話に残り続けることです。先ほど説明したとおり、エージェントは手順のたびに会話全体を読み直すので、重いファイルを序盤に読ませるほど、その後のすべての手順が重くなります。
闇雲に節約する前に、内訳を確認するのが近道です。デスクトップアプリのClaude Codeなら、入力欄の近くにある使用量の表示を開くだけで、次の2つを一度に確認できます。
/contextで確認できますターミナルで使っている場合は、次のコマンドで同じ情報を確認できます。
/context……いまのコンテキストを何が占めているか(CLAUDE.md、MCP、会話履歴など)を表示します/usage……サブスクリプションの利用枠の残りに加え、直近の消費がどのスキル・サブエージェント・MCPサーバーによるものかの内訳を表示します| 習慣 | やり方 | 効く理由 |
|---|---|---|
| 作業が変わったらリセット | /clearで新しいセッションにする |
古い会話を毎回読み直さずに済む。/clear自体はトークンを消費しない |
| 続けたいときは要約 | /compact 〇〇を重視してのように、残す内容を指定して圧縮 |
履歴を要約して軽くできる。ただし要約する処理自体に大きな読み込みが発生する |
CLAUDE.mdは短く |
200行以内を目安に、特定の作業の手順はスキルへ | 毎回読み込まれる“固定費”が減る |
| 重い作業はサブエージェントに | 大量の資料の読み込みや下調べを任せ、結果の要約だけ受け取る | 大量の出力がメインの会話に積まれない |
| 頼み方を具体的に | 「資料をいい感じに直して」ではなく「『提案書.pptx』の3枚目の売上の数字を、今月の実績に更新して」 | 探索のために読むファイルが減る |
| モデルと思考量を作業に合わせる | 日常の作業はSonnet、込み入った判断が要る作業はOpus、半日がかりの大きな仕事や原因の見えない調査だけFable。簡単な作業は/effortで思考量を下げる |
単価の高いモデル・長い思考を必要な場面に限定できる(Fableはプランによって、利用枠ではなく追加料金の対象になる) |
トークンを「数える」よりも、エージェントに余計な情報を持たせないことが、いちばん効く節約術です。
ここまで「トークンは料金の単位」と説明してきました。では実際に、1トークンいくらなのか。主要3社のAPI料金を並べてみます。
なお、ChatGPTやClaude、Geminiのアプリを月額プランの利用枠の範囲で使うぶんには、このトークン単価で請求されることはありません(枠を超えた分を追加料金で使う場合などを除く)。以下は、APIでAIを業務システムに組み込んだり、Claude Codeを従量課金で使ったりする場合の料金です。
| 会社 | モデル | 位置づけ | 入力 | 出力 |
|---|---|---|---|---|
| Anthropic | Claude Fable 5.1 | 最上位。長時間の自律作業向け | $10 | $50 |
| Anthropic | Claude Opus 5.5 | 高性能。業務・エージェント作業の主力 | $4 | $20 |
| Anthropic | Claude Sonnet 5 | 標準。性能と価格のバランス型 | $2 | $10 |
| Anthropic | Claude Haiku 4.5 | 軽量・高速 | $1 | $5 |
| OpenAI | GPT-6 Astra | 最上位 | $10 | $50 |
| OpenAI | GPT-6 Sol | 標準 | $2 | $10 |
| OpenAI | GPT-6 Luna | 軽量・低価格 | $0.10 | $0.50 |
| Gemini 3.1 Pro(プレビュー版) | 高性能 | $2 | $12 | |
| Gemini 3.8 Flash | 標準 | $0.75 | $3.75 | |
| Gemini 3.5 Flash-Lite | 軽量・低価格 | $0.30 | $2.50 |
公式料金ページ:Anthropic(Claude)/OpenAI/Google(Gemini)
※2026年9月時点、標準料金(米ドル)。Gemini 3.1 Proは入力が20万トークンを超えると単価が上がり(入力$4/出力$18)、OpenAIのモデルも長い入力では単価が上がります。Gemini 3.8 Flashの料金は2026年12月31日までの導入価格で、2027年1月からは入力$1.50/出力$7.50になります。料金は頻繁に改定されるため、利用前に各社の公式ページで確認してください。
表を見ると、2つのことがわかります。
実際の業務に置き換えてみましょう。日本語1万字の資料を読ませて、1,000字の要約を書かせる作業を考えます。先ほどの目安(文字数×1)で、入力1万トークン・出力1,000トークンとして計算しました(1ドル=150円で換算)。
| モデル | 1回あたり | 月2,000回(1日100件×20営業日) |
|---|---|---|
| Claude Fable 5.1 / GPT-6 Astra | 約22.5円 | 約4万5,000円 |
| Claude Opus 5.5 | 約9円 | 約1万8,000円 |
| Claude Sonnet 5 / GPT-6 Sol | 約4.5円 | 約9,000円 |
| Gemini 3.1 Pro | 約4.8円 | 約9,600円 |
| Claude Haiku 4.5 | 約2.25円 | 約4,500円 |
| Gemini 3.8 Flash | 約1.69円 | 約3,380円 |
| Gemini 3.5 Flash-Lite | 約0.83円 | 約1,650円 |
| GPT-6 Luna | 約0.23円 | 約450円 |
※トークンの数え方はモデルごとに違うため、同じ1万字でも実際のトークン数は1〜3割前後ぶれます(たとえばClaudeの新しいモデルは、同じ文章を約3割多く数えます)。会社をまたいだ比較は目安としてご覧ください。
1回あたりは数円でも、毎日大量に処理すれば、モデルの選び方ひとつで月の費用が数万円変わります。まずは標準クラスのモデルで試し、品質に問題がなければ軽量モデルに切り替えられないかを検討するのが、費用を抑える基本の順番です。
なお、この試算には推論モデルが答える前に内部で考える「思考トークン」を含めていません。思考トークンは出力トークンとして課金されるため、難しい処理を任せるほど、実際の料金はこれより高くなります。
最後に、日々の使い方で効く小ワザを3つ。
トークンについて持ち帰っていただきたいのは、次の4点です。
「トークン」という言葉が読めるようになると、AIの料金表も、仕様の説明も、ぐっと具体的に見えてきます。次に長い資料をAIに渡す前に、一度Tokenizerに貼って数えてみてください。それだけで、“通貨”の感覚がつかめるはずです。
この記事を書いた人


 お役立ち資料