次世代のビジネスをつくる、実装と教育のメディア。
検索メニュー
キーワードで探す
長い契約書をAIに貼り付けて要約を頼んだら、後半の条項がまるで無視されていた。何往復もやり取りしているうちに、最初に伝えた「です・ます調で」という指示を守らなくなった。生成AIを仕事で使っていると、こうした場面に一度は出会います。
AIが手を抜いたわけでも、故障したわけでもありません。原因の多くは、コンテキストウィンドウと呼ばれる「AIが一度に読める量の上限」にあります。この記事では、コンテキストウィンドウの仕組みと、ChatGPT・Claude・Geminiでの実際の上限、そして上限にぶつかったときの対処法を整理します。
コンテキストウィンドウとは、AIが1回の回答をつくるときに、一度に目を通せる情報量の上限のことです。「コンテキスト長」とも呼ばれ、単位は文字数ではなくトークン(AIが文章を区切って数える単位)です。
作業机にたとえると分かりやすくなります。AIは、机の上に広げた資料だけを見て回答を書きます。机に載りきらなかった資料は、どれだけ大事でもAIの目には入りません。
この机に載るのは、あなたが貼り付けた資料だけではありません。
これらがすべてトークンに換算されて、1つの枠(作業机)に積み上がっていきます。トークンの数え方そのものは生成AIのトークンとはで詳しく解説しています。
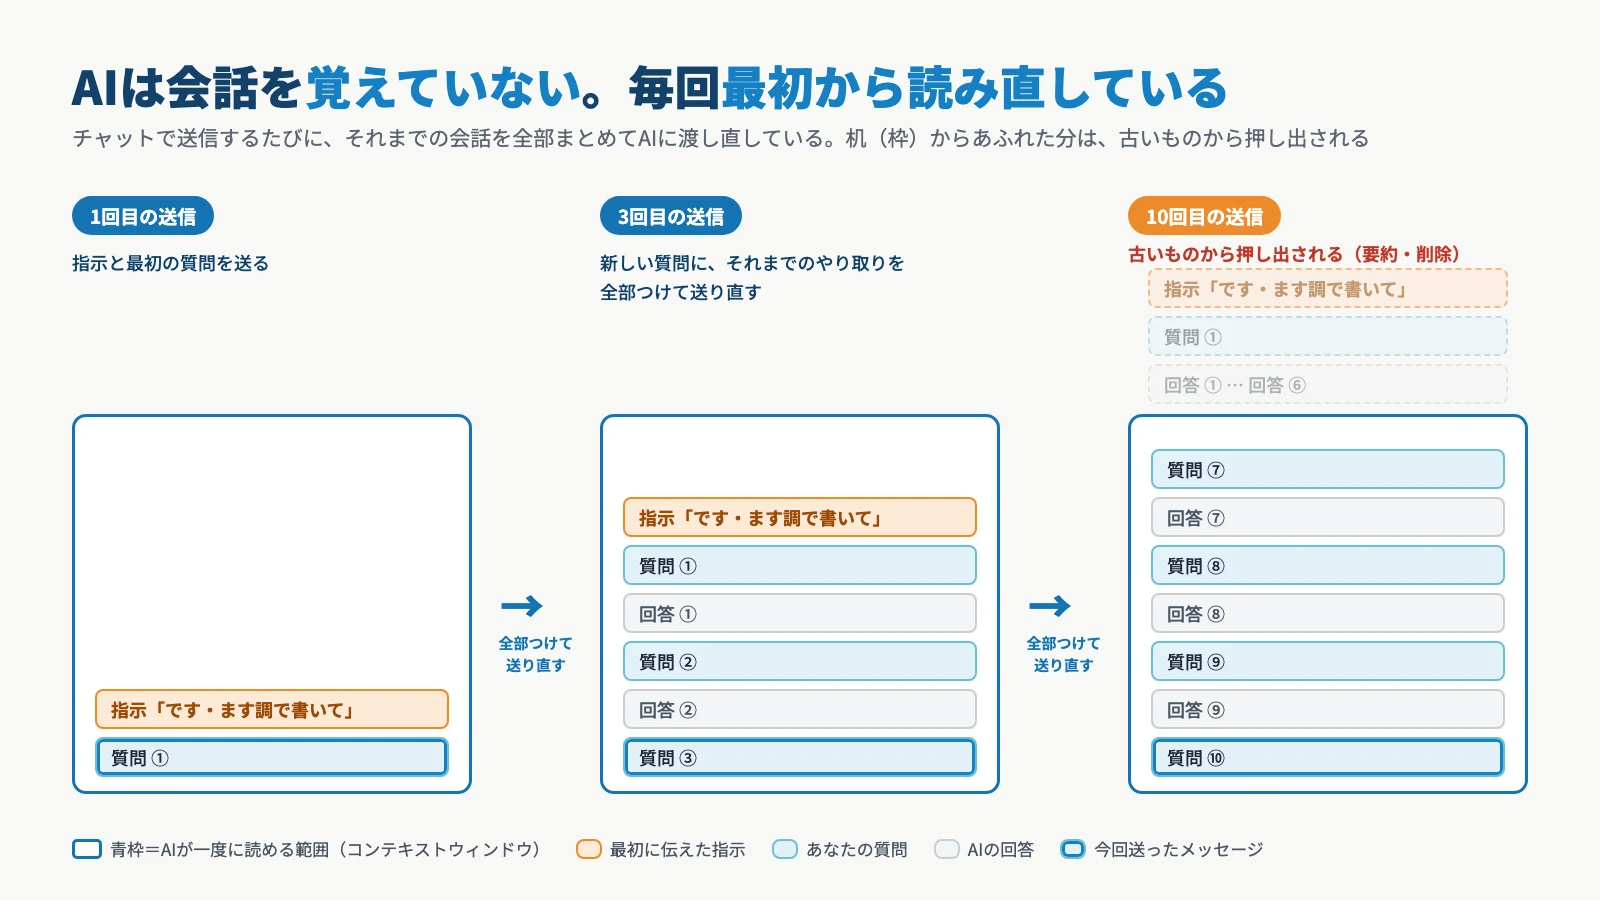
ここがいちばんの誤解ポイントです。チャットAIは、会話の内容を記憶しているわけではありません。あなたがメッセージを送るたびに、それまでの会話を最初から全部読み直して、次の回答をつくっています。モデルそのものは、やり取りの内容を何も覚えていないのです。ChatGPTやClaudeの「メモリ」機能も、保存しておいた情報を会話の冒頭で机に載せ直す仕組みなので、同じように枠を使います。AIが言葉を生み出す仕組みはLLMの仕組みで解説しています。
会話が短いうちは、机の上に全部が載るので問題は起きません。ところが会話が長くなって机からあふれると、どこかを削るしかなくなります。
上限に近づいたときの動きは、サービスによって違います。
会話の序盤に伝えた条件ほど押し出されやすいので、「長い会話の後半で急に指示を守らなくなる」という現象が起きるのです。
もう一つ知っておきたいのが、枠に収まっていれば全部を正確に読めるわけではないという点です。長い資料では、冒頭と末尾の情報に比べて、真ん中あたりの情報をAIが見落としやすい傾向が、2023年の研究で報告されています(「Lost in the Middle」と呼ばれる現象)。その後のモデルでも程度の差はあれ指摘されていて、Anthropicは、読み込む量が増えるほど精度が落ちる現象を「context rot」と呼んで注意を促しています。
「100万トークン入るから、関係ありそうな資料を全部入れておこう」は逆効果になりがちです。必要な資料に絞って渡したほうが、回答の精度は上がります。
上限には、APIで使うときのモデルの上限と、チャットアプリで使えるプランごとの上限の2種類があります。ふだんブラウザやスマホでAIを使っている人にとって大事なのは、後者です。
2026年10月時点で、各社の公式ページに記載されている個人向けプランの上限は次のとおりです。
| サービス | 無料プラン | 個人向け有料プラン | 上位プラン | 出典 |
|---|---|---|---|---|
| ChatGPT(即答モード) | 2.7万トークン | 5.4万トークン(Go・Plus) | 12.8万トークン(Pro) | ChatGPT 料金(ページ下部の比較表) |
| ChatGPT(推論モード) | 場合により異なる | 25.6万トークン(Go・Plus) | 40万トークン(Pro) | ChatGPT 料金(ページ下部の比較表) |
| Gemini | 3.2万トークン | 12.8万トークン(AI Plus) | 100万トークン(AI Pro・AI Ultra) | Gemini アプリ ヘルプ |
| Claude | 記載なし | 使うモデルで決まる(Pro):100万トークン(Fable 5.1・Opus 5.5・Opus 5・Sonnet 5.5・Sonnet 5)、50万トークン(Fable 5・Opus 4.6〜4.8・Sonnet 4.6)、それ以外のモデルは20万トークン | Proと同じ(Max) | Claude Help Center |
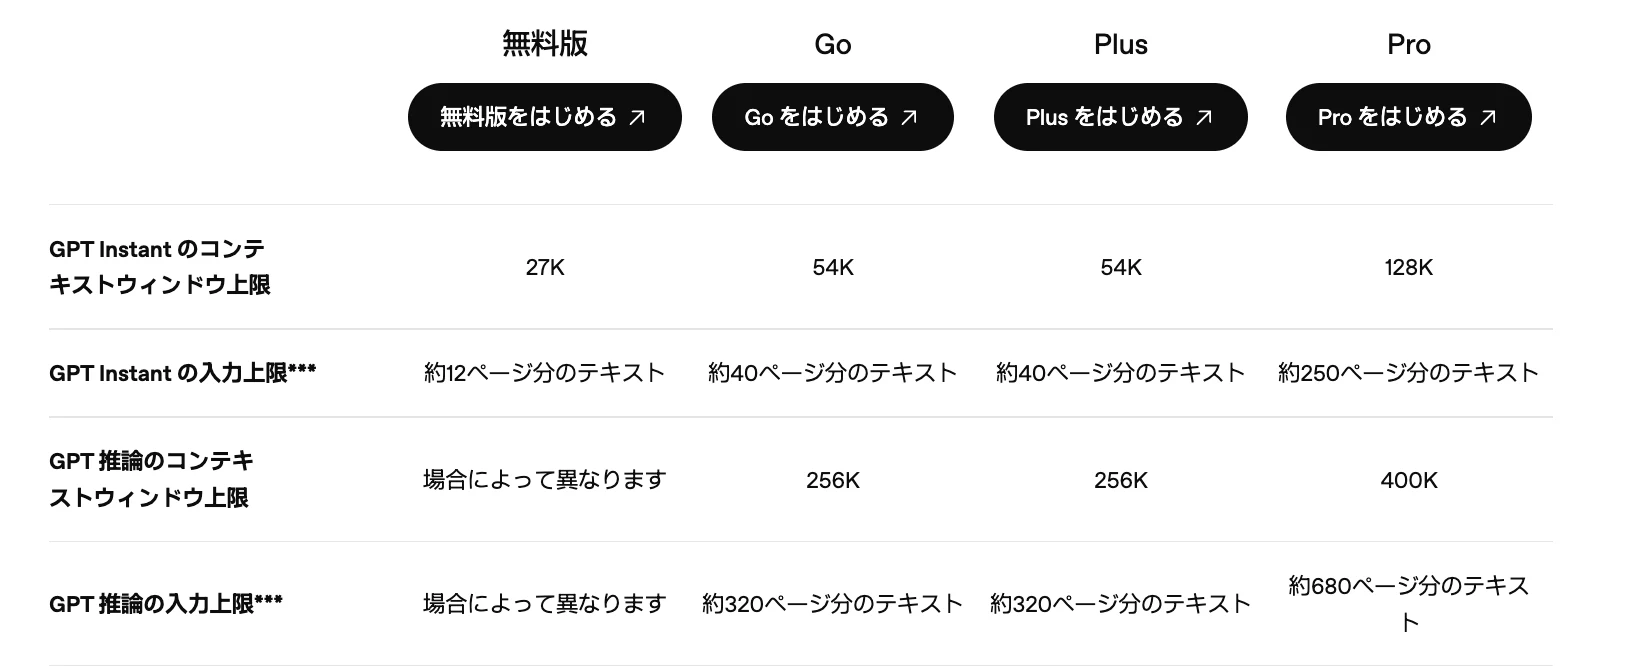
ChatGPTの数字は、料金ページの下部にある「各プランの機能を比較」の表に載っています。ChatGPTにログインした状態で料金ページを開くと別の画面に移動してしまうため、確かめるときはログアウトした状態で開いてください(出典:OpenAI「ChatGPT 料金」ページ、2026年10月3日取得)。
表から分かるのは、同じサービスでも、プランによって読める量が大きく違うということです。Geminiでは無料プランと上位プランで30倍以上、ChatGPTの即答モードでも約5倍の差があります。ChatGPTの無料プランの即答モードは2.7万トークンで、OpenAIは料金ページの比較表で、入力できる量を「約12ページ分のテキスト」と案内しています。数十ページの資料を貼って途中から話がかみ合わなくなるのは、珍しいことではありません。
会社で契約しているプランの場合は、次のようになります(2026年10月時点)。
| サービス | 標準的なプラン | 上位プラン | 出典 |
|---|---|---|---|
| ChatGPT(即答モード) | 5.4万トークン(Business) | 12.8万トークン(Enterprise) | ChatGPT 料金(法人向け) |
| ChatGPT(推論モード) | 25.6万トークン(Business) | 25.6万トークン(Enterprise) | ChatGPT 料金(法人向け) |
| Gemini(Google Workspace) | 3.2万トークン(Business Starter など) | 100万トークン(Business Standard・Business Plus など) | Gemini アプリ ヘルプ(仕事用アカウント) |
| Claude | 使うモデルで決まる(Team):100万トークン(Fable 5.1・Opus 5.5・Opus 5・Sonnet 5.5・Sonnet 5)、50万トークン(Fable 5・Opus 4.6〜4.8・Sonnet 4.6)、それ以外のモデルは20万トークン | Teamと同じ(Enterprise) | Claude Help Center |
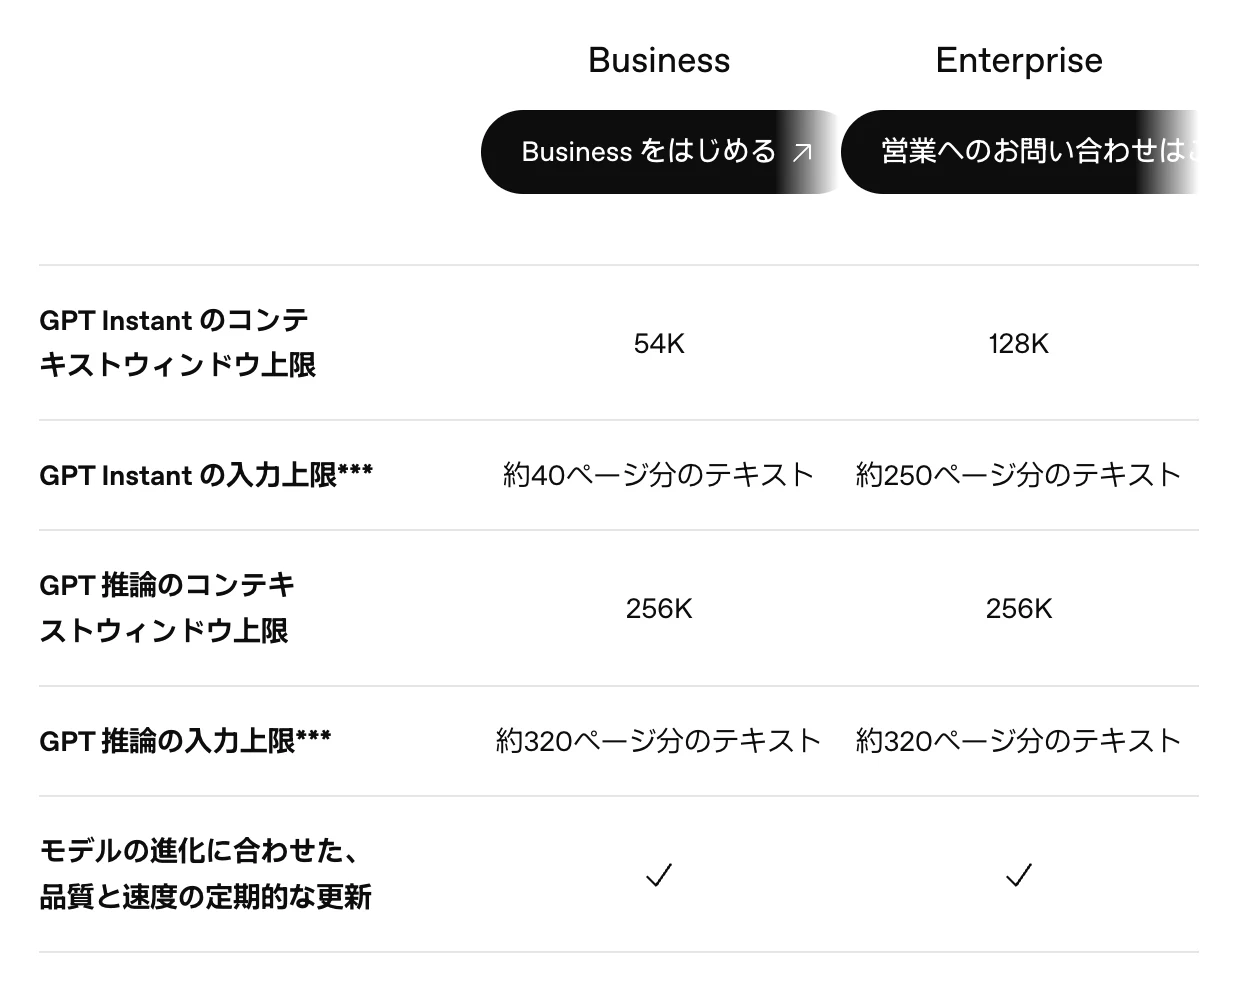
法人向けのChatGPTの数字は、料金ページの「ビジネス・エンタープライズ向け」タブを開き、下部にある「各プランの機能を比較」の表で確かめられます。個人向けと同じく、ChatGPTにログインした状態で開くと別の画面に移動してしまうため、ログアウトした状態で開いてください(出典:OpenAI「ChatGPT 料金」ページ、2026年10月3日取得)。
法人向けで気をつけたいのは、Google WorkspaceのBusiness Starterでは、Geminiの枠が無料プランと同じ3.2万トークンだという点です。Business Standard以上と比べると30倍以上の差があり、「会社のGeminiで長い資料を読ませると途中から話がかみ合わない」という場合は、プラン(エディション)の違いが原因かもしれません。
APIや開発ツールから使う場合は、プランではなくモデルごとの上限が適用されます。2026年10月時点の主力モデルは、どの会社もおおむね100万トークン前後でそろっています。
| 会社 | 主なモデル | コンテキストウィンドウ | 出典 |
|---|---|---|---|
| Anthropic | Claude Fable 5.1 / Opus 5.5 / Sonnet 5.5 | 100万トークン | Anthropic Models overview |
| OpenAI | GPT-6 Astra / GPT-6.1 Sol / GPT-6 Luna | 105万トークン(1,050,000。うち入力に使えるのは最大92.2万) | OpenAI Models |
| Gemini 3.1 Pro(プレビュー版)/ Gemini 3.8 Flash | 約105万トークン(1,048,576。入力の上限で、出力の上限は別に定められている) | Gemini 3.1 Pro・Gemini 3.8 Flash |
モデルの世代が変わるたびにこの枠がどう広がってきたかは、AIモデルはどこが進化するのかで解説しています。
ChatGPTの推論モード、Geminiの思考モード、ClaudeのThinking(思考)のように、答える前にじっくり考えるAIを推論モデルと呼びます。推論モデルは、回答を書く前に、画面には表示されない「思考トークン」を内部で生み出しながら考えます。推論モデルの仕組みや使いどころは推論モデルとは何かで解説しています。
思考トークンに関わる枠は、次の2つです。
思考トークンはAIが生み出すものなので、出力として数えられ、出力の上限から差し引かれます。この点はOpenAI・Anthropic・Googleの公式ドキュメントで共通しています。出力はコンテキストウィンドウの内側に収まるので、思考トークンは全体の枠も使うことになります。
ただし、入力と出力で枠をどう分けるかは会社によって違います。Claudeは1つの枠を入力と出力で分け合い、OpenAIは出力の分をあらかじめ差し引いた入力の上限(GPT-6系で92.2万トークン)を設け、Geminiは入力と出力の上限を別々に定めています。
思考トークンが差し引かれる「1回に出力できる量」は、コンテキストウィンドウとは別に、モデルごとに上限が決まっています。コンテキストウィンドウが100万トークン前後あっても、1回の回答で書き出せるのはその1割前後です(2026年10月時点。Geminiは6%ほど)。
| 会社 | モデル・モード | 出力の上限 | 出典 |
|---|---|---|---|
| Anthropic | Claude Fable 5.1 / Opus 5.5 / Sonnet 5.5(API) | 12.8万トークン | Anthropic Models overview |
| OpenAI | GPT-6 Astra / GPT-6.1 Sol / GPT-6 Luna(API) | 12.8万トークン | OpenAI Models |
| Gemini 3.1 Pro(プレビュー版)/ Gemini 3.8 Flash(API) | 約6.6万トークン(65,536) | Gemini 3.1 Pro・Gemini 3.8 Flash |
思考トークンはこの上限の中から使われます。たとえば出力の上限が約6.6万トークンのモデルで、考えるのに3万トークンを使えば、回答そのものに使えるのは残りの約3.6万トークンです。
2つの枠が同時にかかっていることは、具体的な数字で考えると分かりやすくなります。コンテキストウィンドウが100万トークン、出力の上限が12.8万トークンのモデル(Claudeの新しいモデルがこれにあたります)に、90万トークン分の資料を渡し、AIが8万トークン考えてから、3万トークンの回答を書こうとした場合です。
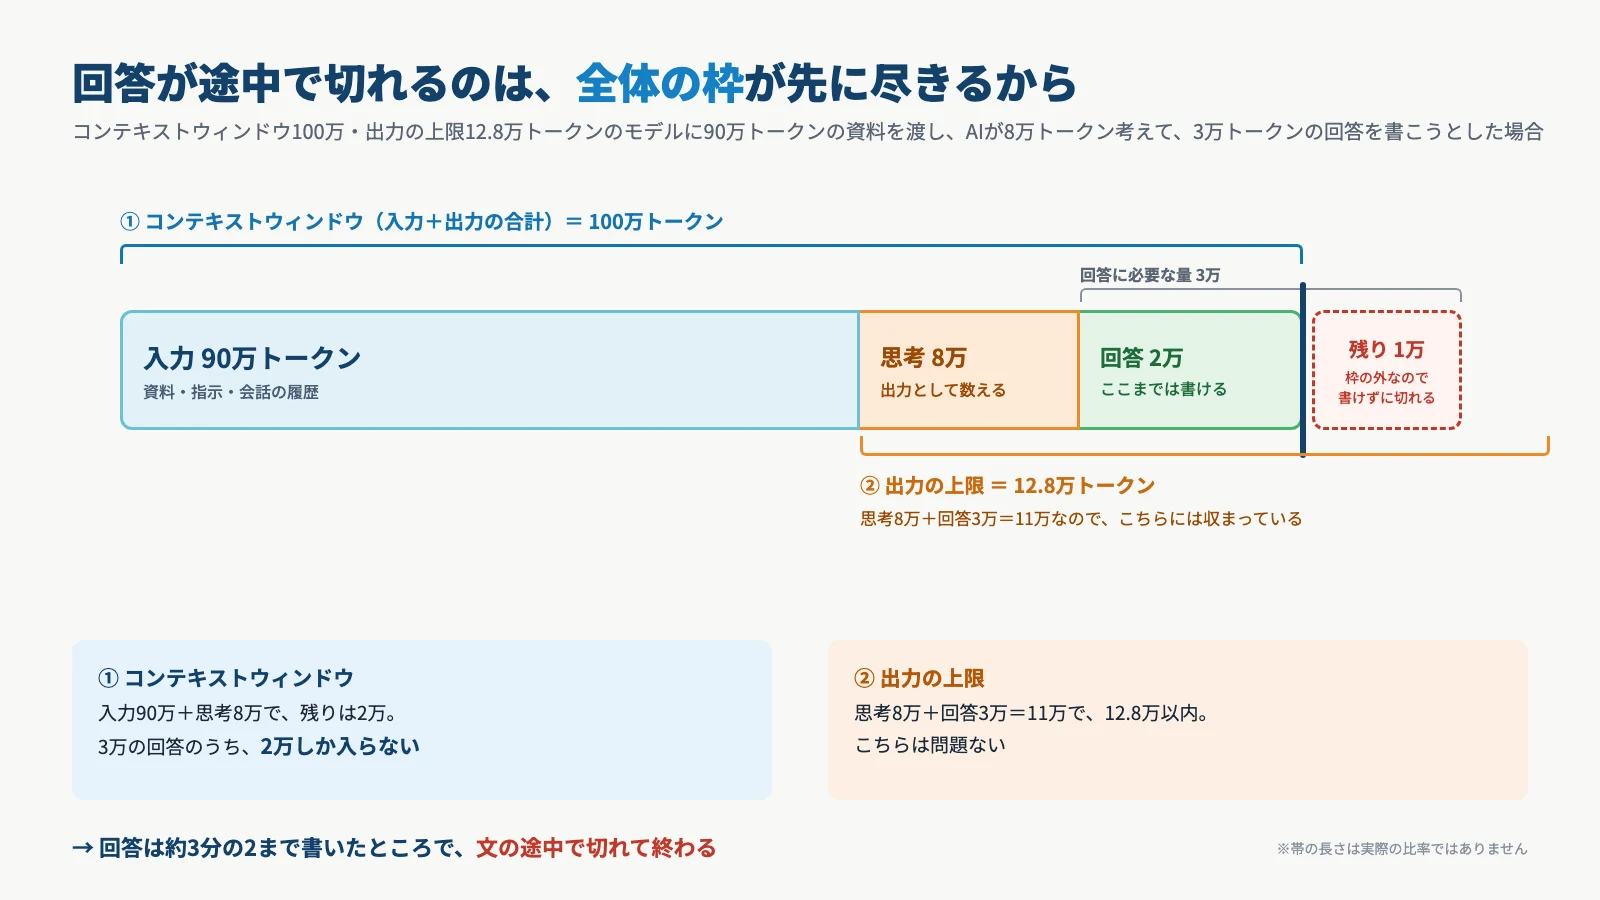
AIは、残りの枠に合わせて回答を短くまとめてくれるとは限りません。Anthropicのドキュメントでは、生成はコンテキストウィンドウの上限に達したところで止まると説明されています。Googleのドキュメントでも、考えている途中で出力の上限に達すると、回答が途中で切れたり空になったりすると説明されています。推論モデルに長い資料を渡すときは、入力で枠を埋めきらず、考える余地と答える余地を残しておくことが大切です。
コンテキストウィンドウの上限はトークンで決まっていますが、私たちが気になるのは「日本語で何文字まで入るか」です。トークンと文字数の関係は、言語によって変わります(2026年9月時点、OpenAIのTokenizerで計測)。
見積もりには次の式が便利です。
必要なトークン数(概算)= 日本語の文字数 × 1(余裕を見るなら、2〜3割増しで考える)
この式を逆に使えば、枠に入る文字数の目安が分かります。余裕を差し引いて、実際に貼れる量の目安を並べると次のとおりです。
| コンテキストウィンドウ | 日本語の文字数(×1) | 安心して貼れる目安 |
|---|---|---|
| 2.7万トークン(ChatGPT無料プランの即答モード) | 約2.7万字 | 約2万字 |
| 3.2万トークン(Gemini無料プラン) | 約3.2万字 | 約2.5万字 |
| 12.8万トークン | 約12.8万字 | 約10万字(文庫本1冊分ほど) |
| 100万トークン | 約100万字 | 約75万字(文庫本7〜8冊分ほど) |
ただし、この枠には会話の履歴やAIの回答も入ります。会話が進んでいるチャットでは、貼れる量はさらに少なくなると考えてください。おおよそのトークン数を確かめたいときは、OpenAIのTokenizerに文章を貼ってみてください。この目安はOpenAIの数え方によるもので、ClaudeやGeminiでは数え方が異なるため多少前後します。トークンの数え方や料金との関係は、生成AIのトークンとはで詳しく解説しています。
手軽で効果を実感しやすい方法です。用件が変わったら新しいチャットを開きましょう。前の会話の続きが必要なら、それまでの要点をAIにまとめさせ、そのまとめを新しいチャットの最初に貼ると、机をきれいにしたうえで必要な情報だけを引き継げます。
口調・出力形式・前提条件などの守ってほしい指示は、会話のあちこちに散らさず、冒頭にまとめて伝えます。忘れられたと感じたら、同じ指示をもう一度送り直すのが効果的です。指示の書き方はプロンプトの書き方も参考にしてください。
長い資料は章ごとに分けて渡し、それぞれで要約や確認をさせます。「第3章の契約解除の条項だけ」のように、必要な箇所だけを渡すほうが、見落としも減ります。
大量の資料を何度も参照したい場合は、チャットに毎回貼るのではなく、資料を保管しておける機能を使います。ChatGPTやClaudeのプロジェクト機能、GoogleのNotebookLMなどがこれにあたります。社内文書のように量が多いものは、質問に関係する部分だけを検索して渡すRAGという仕組みが向いています。
Claude CodeのようなAIエージェントは、ファイルの中身やコマンドの実行結果を次々に読み込むため、枠が埋まるのが早くなります。/compact(会話を要約して空きをつくる)や/clear(会話をリセットする)で、こまめに机を片付けるのがコツです。
コンテキストウィンドウの仕組みを知っておくと、「AIが急に指示を守らなくなった」「話がかみ合わなくなった」と感じる場面の多くに、理由と対処法が見えてきます。
この記事を書いた人


 お役立ち資料